2026년 9월, Jev가 공개된 지 다섯 번째 날에 쓴 글. 이건 변화가 아주 빠른 주제라, 글에 나오는 가격·지연 시간·테스트 데이터는 이미 낡았을 수 있어요. 공식 문서와 1차 출처를 최대한 대조해 봤지만, 그래도 원문을 직접 한 번 더 확인해 보길 권해요.
지난 2년 동안 우리는 말 많은 AI에 익숙해졌어요. 오늘이 월요일이냐고 물으면 요일 제도의 기원부터 설명하고, 일과 휴식의 균형을 챙기라고 일러준 뒤, 마지막으로 더 도와드릴 일이 있는지 묻죠.
그러다 Jev가 나타났어요. 질문을 하면 옵션 하나와 확률 하나만 돌려줘요. 한 글자도 더 없이요. 단톡방에서는 한마디도 안 하지만 내는 결과물은 언제나 빈틈없는 회사 동료를 꼭 닮았어요.
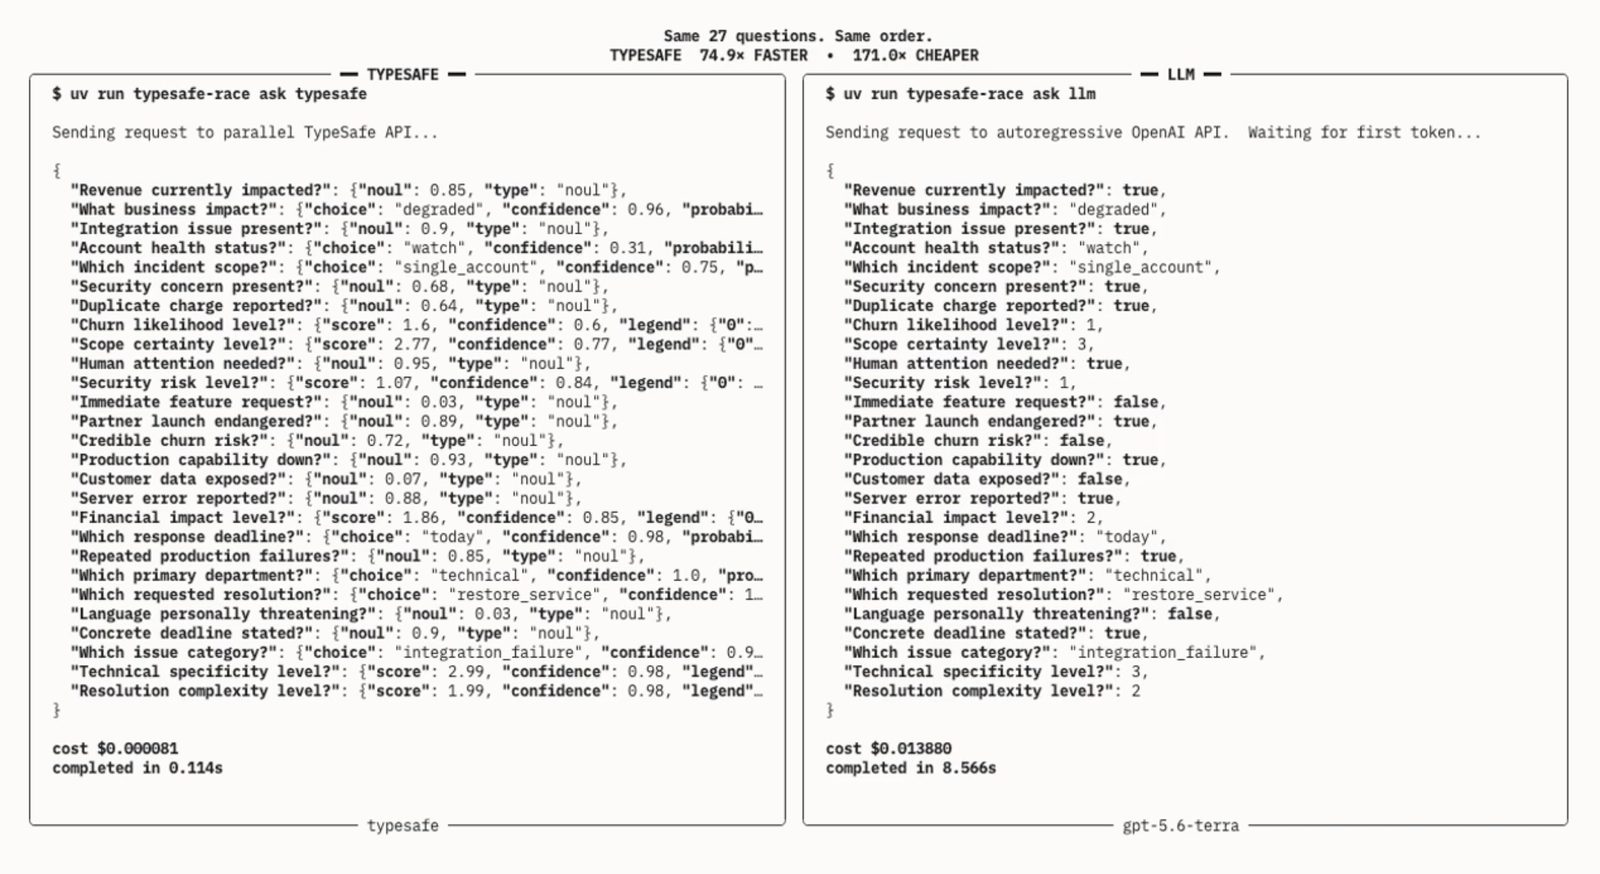
출처: TypeSafe AI 공식 데모, TechCrunch 2026-09-18 본 별도를 통해 전재. 스크린샷 속 74.9× / 171.0×는 그 데모 한 번의 결과일 뿐, 마음대로 외삽할 수 있는 평균값이 아니에요.
1. Jev는 무엇인가
Jev는 TypeSafe AI가 2026년 9월 15일에 낸 첫 번째 공개 모델이에요. 공식 분류명은 System One 모델: 대니얼 치너먼의 『생각에 관한 생각』에 나오는 '시스템 1' 개념을 빌려온 것으로, 깊이 생각하지 않고 빠르게 판단하는 직관적 사고를 뜻해요. 이와 반대되는 게 ChatGPT, Claude처럼 한 글자 한 글자 써 낸리가며 천천히 생각하는 대형 모델이죠. 모델 이름은 경제학자 윌리엄 스탠리 제번스(William Stanley Jevons)에서 따왔어요. 공식의 의도는 이래요: 지능이 싸지면 사용량은 줄지 않고 늘어난다.
창업자 Diogo Almeida는 OpenAI 연구원 출신이에요. TechCrunch 본 별도는 그가 ChatGPT와 훗날 RLHF라 불리게 된 지시 따르기 훈련에 참여했다고 썼어요. 본인의 발표문은 좀 더 좁게 말해요: OpenAI에서 언어 모델이 지시를 듣고 사람과 대화하는 법을 배우게 하는 작업을 도왔다고요. 나머지 공동 창업자 두 명은 Erik Gafni와 Sasha Sheng이에요. 여러 매체가 TypeSafe가 같은 시기에 DCVC 주도의 4000만 달러 시드 라운드를 마쳤다고 썼는데, 공식 발표문에서 투자 세부 사항은 보지 못했어요. 그래서 언론 본 별도로만 취급할 뿐, 회사가 확인해 준 숫자로는 보지 않아요.
쉽게 말하면:
Jev는 범용 분류기예요. 핵심은 전통적인 분류기처럼 작업마다 훈련할 필요가 없다는 거예요.
예전에는 고객 지원 티켓을 자동 분류하려면 먼저 수천 건의 데이터를 사람이 라벨링하고 전용 모델을 훈련해야 했어요. 어느 날 사장이 '불만' 카테고리를 추가하라고 하면, 끝, 라벨링부터 다시, 훈련도 다시. Jev는 이 단계를 지웠어요: 분류 기준을 호출할 때 텍스트로 바로 넣으면 되고, 기준을 바꾸는 건 몇 줄 고치는 일이에요.
한 가지 분명히 해 두면: Jev는 클로즈드 소스예요. 가중치 공개도 없고, 로컬 배포도 안 되고, 호스팅 API로만 쓸 수 있어요. 공식 발표문에는 자기들의 평가를 미국 서부 해안의 노트북에서 돌렸고 "this is where our service is currently based"라고 쓰여 있어요. 지금 서버가 미국 서해안에 있다고 이해하면 돼요. 공식 API는 대기열이 있어요. Vercel AI Gateway 경로는 현재 기다릴 필요가 없어요.
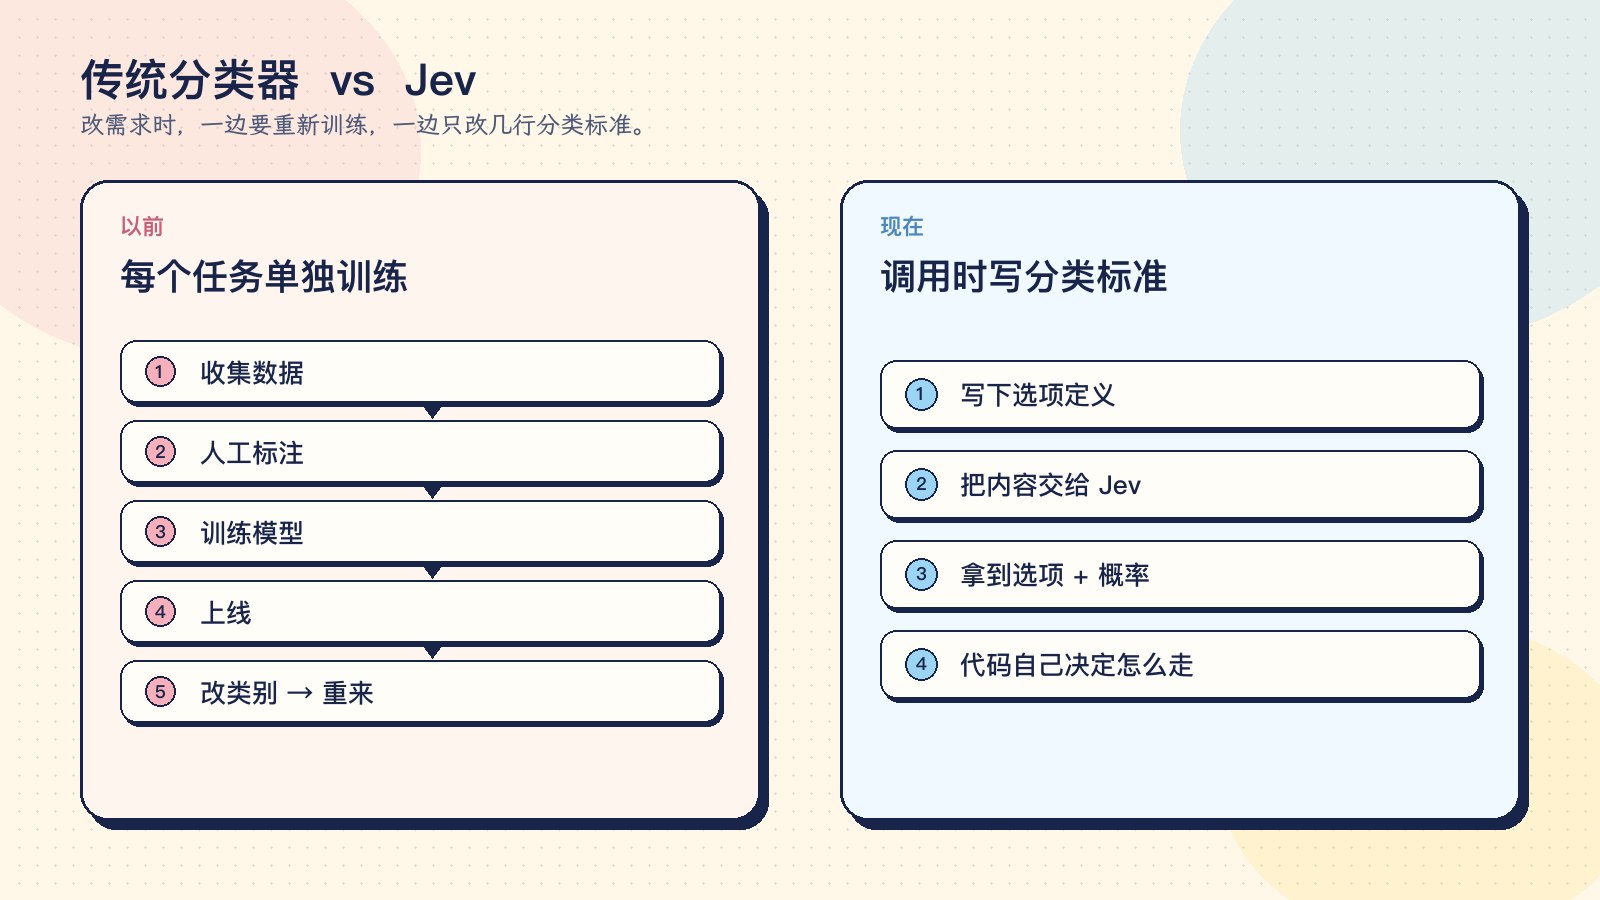
개념도. 왼쪽은 전통적인 분류기의 경로, 오른쪽은 Jev의 호출 방식이에요.
2. Jev가 할 수 있는 것
공식 문서에는 세 종류의 질문, 즉 세 가지 '프리미티브'만 있어요:
- Choice / 객관식: 당신이 준 몇 개의 옵션 중 하나를 고르는 문제, 예를 들어 "이 티켓은 어느 부서로 본내야 하나". 최대 255개 옵션.
- Score / 점수 매기기: 당신이 정의한 순서 있는 등급 안에서 점수를 매기는 문제, 예를 들어 "이 문제는 얼마나 긴급한가".
- Noul / 예·아니오: '예'일 확률을 돌려주는 문제. 공식 명칭은 Noul이에요. Vercel의 AI SDK와 changelog에서는 흔히 Boolean으로 쓰여 있어요. 같은 종류의 질문이에요.
모든 답에는 확률이 붙고, 객관식과 점수 문제에는 confidence도 줘요. 여기가 가장 재미있는 지점인데, 뒤에서 자세히 다룰게요.
투박해 보이지만, 소프트웨어 안에는 사실 이런 판단이 널려 있어요. 대표적인 용도는 이래요:
- 티켓·메시지 분배: 어느 팀에 넘길지, 긴급도가 어느 정도인지 판단.
- 에이전트의 의사결정 노드: 다음에 어떤 도구를 호출할지, 계속할지, 재시도할지, 사용자에게 물을지, 멈출지.
- 안전 점검과 가드레일: AI가 명령을 실행하기 전에 위험한 작업인지 판단하거나, 다른 모델의 출력이 선을 넘지 않았는지 검사. Vercel 엔지니어는 fx 기본 모드에서 Luna 위에서 돌던 명령 안전 검토를 이걸로 바꾼 적이 있어요.
- 모델 라우팅: 요청이 쉬운 문제인지 어려운 문제인지 판단해서, 쉬운 건 싼 모델로, 어려운 건 비싼 모델로 본내는 방식. LangChain에는 이미 실험적 미들웨어
ModelRouterMiddleware가 있고, Jev로 고위험 도구 호출을 가로막는AutoModeMiddleware도 있어요.
잘 맞는 상황에는 공통점이 있어요: 답을 미리 나열할 수 있고, 판단 횟수가 많다는 것. 하루에 수십 번 판단하는 일이라면 무슨 모델을 쓰든 상관없어요. 하루 수십만 번, 혹은 사용자가 클릭할 때마다 한 번씩 판단해야 한다면 Jev의 가치가 드러나요.
반대로 글을 쓰거나, 계산하거나, 왜 그렇게 판단했는지 설명해야 하는 일에는 어울리지 않아요. 진짜로 못 해요. 공식도 스스로 말해요: 문자열 생성을 포기했다고.
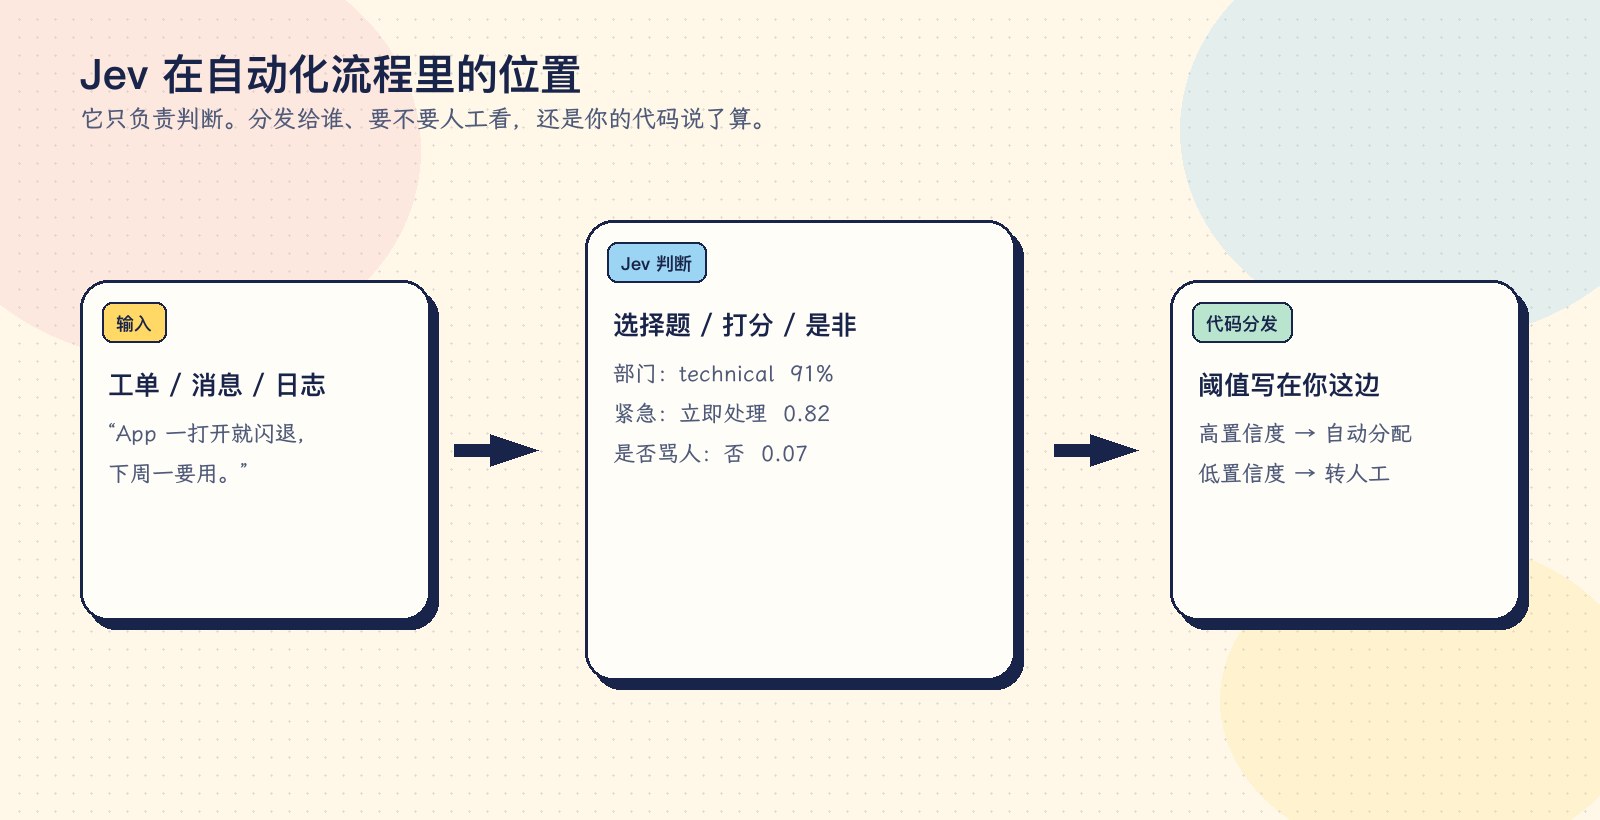
개념도. Jev는 판단만 할 뿐, 누구에게 배정할지 사람이 볼지는 여전히 당신의 코드가 정해요.
3. Luna보다 나은 점
Jev의 가격과 포지셔닝이 겨냥하는 건 GPT-5.6 Luna, Claude Haiku 같은 싸고 빠른 소형 모델 급이에요. 그래서 여기서는 Luna와 비교해요. 숫자는 세 층으로 나뉘어요: 공식 자체 수치, Vercel 엔지니어의 수치, 커뮤니티 독립 테스트. 섞어 읽지 마세요.
1. 빠르다
가장 실질적인 장점이에요.
커뮤니티에서 독립 테스트를 한 사람이 있어요: 30건의 티켓 분배 테스트에서 Jev의 중앙값 지연은 575 ms, Luna는 1472 ms로 약 2.6배 빨랐어요. 또 다른 댓글 분류 테스트에서는 중앙값 지연이 0.647 s 대 1.556 s로 약 2.4배. 공식 수치는 더 과장돼 있어요: 엔드투엔드 70–500 ms, 대형 모델의 3–329초와 비교하며, System One 작업에서는 40~200배까지 간다고 해요. 홈페이지의 "193.6x Faster"라는 문구는 자기들의 workflow evals에서 나온 것으로, 공식도 이게 "실제 세계 이득의 높은 쪽"이라고 인정해요. Vercel은 fx의 명령 안전 검토를 Luna에서 Jev로 바꿨는데, 엔지니어가 공개적으로 말한 수치는 5~18배(p95에서 18배까지)였어요. Vercel의 정식 changelog에는 이 숫자가 없고 TypeSafe의 193.6배만 전하고 있어요.
1초와 0.3초는 배치 처리에는 별 차이가 없어요. 하지만 판단이 사용자의 클릭 직후마다, 혹은 AI 에이전트가 한 걸음 남기기 전마다 일어난다면, 이 지연은 층층이 쌓여 결국 사용자가 체감하는 버벅임이 돼요.
2. 싸다
공식 가격은 아주 명확해요: 입력 100만 토큰당 0.042달러(즉 10억 토큰당 42달러), 출력은 물료. 출력할 게 애초에 거의 없으니까요. 공식도 솔직하게 인정해요: 이 가격에 보조금이 없다는 걸 증명할 수 없다고요.
홈페이지의 "444.6x Cheaper"는 비싼 대형 모델과, 자기들 workflow 기준으로 비교한 수치예요. Luna와 비교하면 두 건의 커뮤니티 독립 테스트에서 대략 4~5배 쌌어요: 티켓 테스트에서는 1000건당 0.022달러 대 0.088달러, 댓글 테스트에서는 알려진 건당 비용이 약 0.000032달러 대 0.000154달러.
솔직히 Luna는 원래 충분히 싸요. 이 정도 차이는 대부분의 사람에게 별 의미가 없어요. 규모가 어느 정도 커져야 의미가 생겨요.
3. 확률을 믿을 수 있다
이게 Jev의 진짜 독특한 점이에요. Luna에게 신뢰도를 달라고 하면 0.9라고 말하는데, 이 숫자는 "말한 것"에 가까워서 실제로 맞는지를 잘 반영하지 못해요. TypeSafe는 이걸 위해 RLCD(Reinforcement Learning for Calibrated Decisions)라는 방법으로 훈련했어요. 목표는 90%라고 말할 때 실제로 대략 90%가 맞는 거예요.
이게 믿을 만하다면 아주 실용적인 걸 할 수 있어요: 신뢰도가 높으면 자동 처리하고, 낮으면 사람에게 넘기는 것. 회사 입장에서 아끼는 사람 재검토 비용이 API 비용 절감보다 훨씬 커요. 다만 지금 이 주장은 주로 공식에서 나온 것이고, 훈련 세부와 보정 오차에 대한 공개 논문은 없어요. 실제 데이터로 직접 검증해 보길 권해요.
4. 형식이 깨진 답을 출력하지 않는다
Luna로 분류하다 본면 가끔 JSON 형식이 틀어지거나, 준 적 없는 옵션을 지어내는 경우가 있어요. Jev는 구조적으로 그런 문제가 없어요. 당신이 정의한 옵션 중에서만 고를 수 있거든요.
공식은 이걸 "제로 환각"이라 불러요. 이 표현에는 할인이 필요해요: 공식 스스로 설명했듯 이 0%는 실측이 아니라 "schema matching is guaranteed"라는 뜻이에요. 존재하지 않는 옵션을 주지는 않지만, 존재하는 옵션을 잘못 고를 수는 충분히 있고, 그것도 아주 자신 있게 틀릴 수 있어요.
정확도에 대해 솔직하게
정확도에서 Jev가 확실히 이기는 건 아니에요.
- 커뮤니티 30건 티켓 테스트: Luna는 세 항목 전부 맞힌 게 28/30, Jev는 25/30. Jev의 전형적인 틀리는 방식은, 아주 차분한 어조의 장애 보고 두 건을 "고객이 화남"으로 판정한 거예요.
- 커뮤니티 100건 댓글, 각 3회 실행: Luna 필드 정확도 97.13%, Jev 96.13%, 1%포인트 차이. 저자 자신도 썼듯 이건 합성 데이터라 범용 순위로 쓸 수 없어요.
- 공식 workflow evals: Jev 67.8%, Luna 66.8%, Jev가 1점 높아요. 하지만 이 평가의 정답지는 GPT-6 Astra와 Claude Fable 5.1의 평균 출력이고, 사람이 라벨링한 게 아니에요. Dev.to에 이 방법론을 잘 핵부한 글이 하나 있어요.
이 테스트들은 샘플이 다 작아서 어느 것도 뭘 증명하진 못해요. 제 결론은 이거예요: 정확도는 비슷하고, Jev는 빠르고, 싸고, 형식이 날아가지 않으며, 임계값을 걸 수 있는 확률을 기꺼이 준다는 점에서 이긴다.
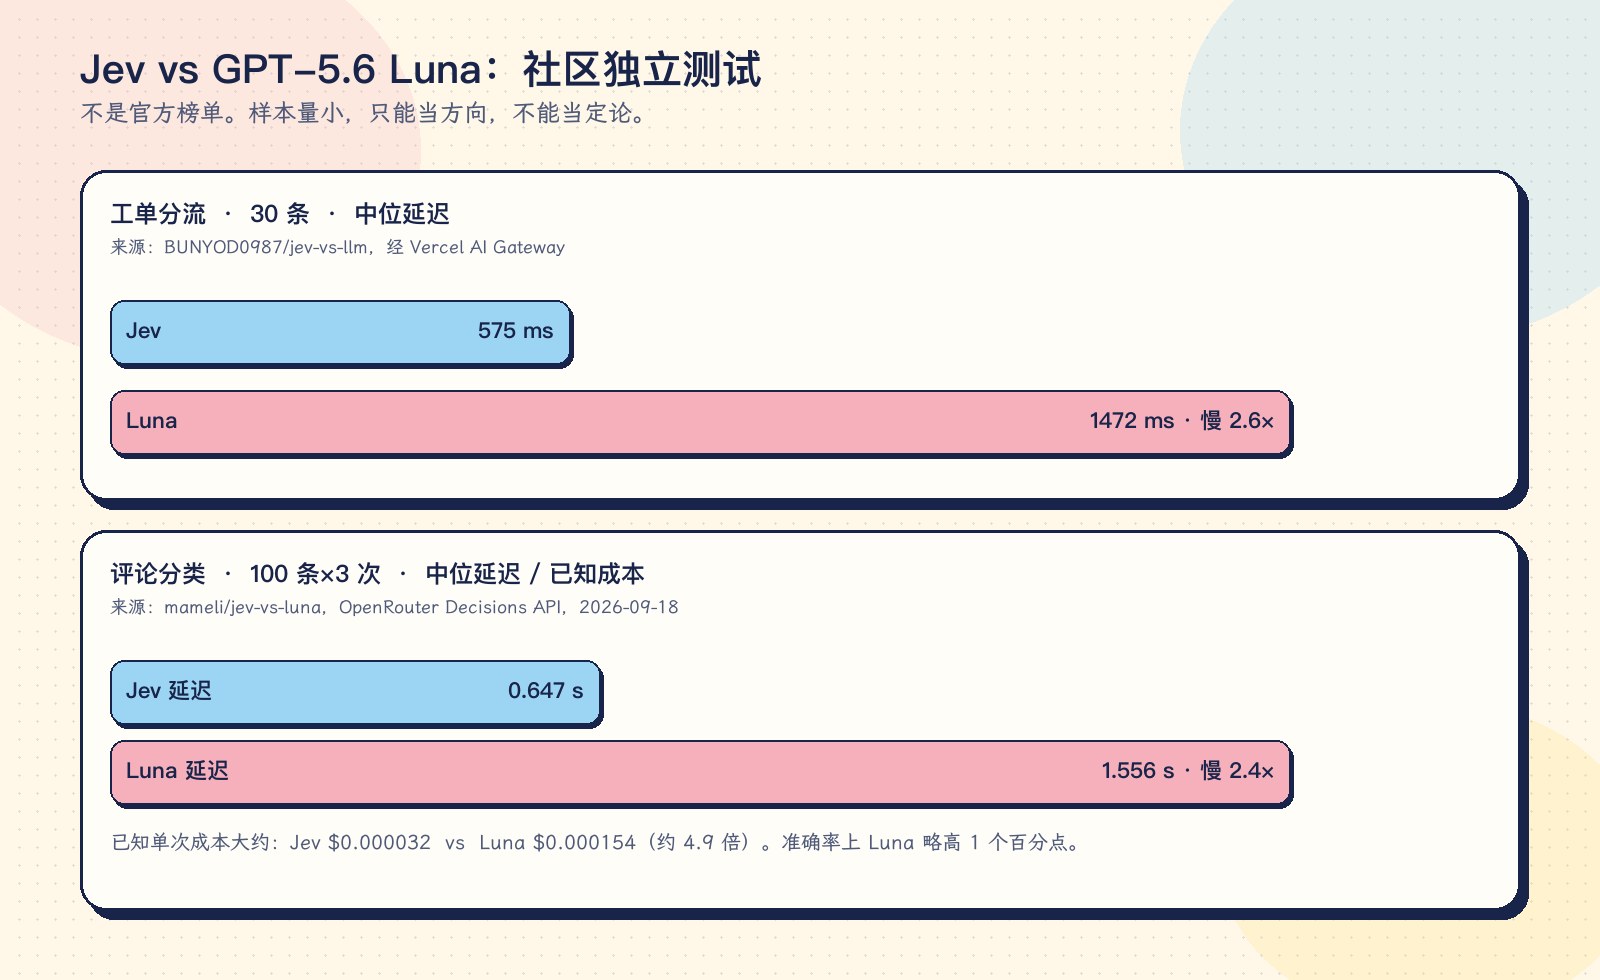
BUNYOD0987/jev-vs-llm과 mameli/jev-vs-luna가 공개한 숫자를 바탕으로 다시 그린 것. 샘플이 작아서 이 두 테스트에서의 방향성만 보여줘요.
4. 어떻게 쓰나
연결 방법
제가 본 경로는 세 가지예요:
- 공식 API:
POST https://api.typesafe.ai/v1/systemone, 모델 ID는jev-latest. 먼저 대기열에서 자격을 신청해야 해요. - Vercel AI Gateway: 대기 불필요, 모델 ID는
typesafe-ai/jev, changelog에는 가격이 같다고 쓰여 있어요. AI SDK 7에서는 실험적evaluate인터페이스를 써요. - OpenRouter: 모델 ID는
~typesafe/jev-latest, 일반 chat completions가 아니라 Decisions API를 거쳐요. 제가 확인한 표시 가격도 입력 0.042달러 / 100만 토큰, 출력 0이에요.
LiteLLM도 패스스루를 지원해요: https://api.typesafe.ai를 프록시의 /typesafe로 바꾸면 돼요.
호출은 어떻게 생겼나
두 가지를 줘야 해요: state는 판단할 내용, questions는 물어볼 질문. 한 번에 여러 개를 물을 수 있고 병렬로 답해요. 아래는 공식 문서 구조를 따륐되, 티켓 내용은 제가 더 익숙한 예로 바꿨어요:
POST https://api.typesafe.ai/v1/systemone
{
"model": "jev-latest",
"state": "앱 업데이트 후에 열기만 하면 바로 꺼져요. 벌써 사흘째인데, 다음 주 월요일에 이걸로 보고서를 내야 해요.",
"questions": {
"department": {
"type": "choice",
"instructions": "이 티켓은 어느 팀에 넘겨야 할까요?",
"criteria": {
"billing": "결제, 인보이스, 환불 관련",
"technical": "장애, 충돌, 기능 이상",
"sales": "가격 문의, 플랜 업그레이드, 신규 계정"
}
}
}
}
돌아오는 건 대략 이런 모습이에요(예시이며, 실제 호출의 원문이 아니에요):
{
"answers": {
"department": {
"type": "choice",
"choice": "technical",
"probabilities": { "billing": 0.04, "technical": 0.91, "sales": 0.05 },
"confidence": 0.89
}
}
}
예·아니오 문제는 공식 응답에서 "type": "noul"에 0~1의 noul 필드가 붙어요. Vercel SDK에서는 boolean과 probability를 보게 돼요. 결과를 받은 뒤 어떻게 할지는 당신의 코드가 정해요. 예컨대 신뢰도가 0.9보다 높으면 자동 배정하고, 그보다 낮으면 사람에게 넘겨서 한번 보게 하는 식이에요.
핵심: 프롬프트를 잘 쓰기
Jev의 "프롬프트"는 대형 모델용 prompt와 좀 달라요. 긴 문단 하나가 아니라 세 덩어리로 나뉘어 있어요: 판단할 내용, 각 질문이 무엇을 묻는지, 각 옵션의 정의. 결과가 좋고 나쁘고는 주로 옵션 정의를 얼마나 명확하게 썼는지에 달려 있어요. 예전에 라벨링 데이터에 쏟던 공을 이제 여기에 쏟아요.
몇 가지 요점:
1. 옵션 사이의 경계를 못 박기
위의 30건 티켓 테스트에서 Jev는 아주 차분한 어조의 장애 보고 두 건을 "고객이 화남"으로 판정했어요. 이유는 짐작하기 쉬워요: "문제가 심각하다"와 "고객이 화났다"를 혼동한 거예요.
모호한 쓰기:
"criteria": {
"angry": "고객이 화남",
"calm": "고객이 화나지 않음"
}
명확한 쓰기:
"criteria": {
"angry": "비난, 반문, 감탄, 별점 테러나 환불 협박처럼 문장에 뚜렷한 감정 표현이 있는 경우. 문제 자체의 심각도가 아니라 어조만 본다.",
"calm": "차분한 어조로 문제를 설명하는 경우. 문제가 아무리 심각핮도(예: 시스템 완전 마비) 문장이 차분하면 이 유형으로 본다."
}
두 번째 쓰기는 가장 헷갈리기 쉬운 상황을 직접 짚어 줘요. 어디서 틀릴 것 같은지 짐작되면, 그걸 정의에 써 넣어요.
2. 한 질문에는 한 가지만 묻기
어느 부서로 본낼지, 얼마나 긴급한지, 환불해 줄지를 알고 싶다면 세 질문으로 나눠서 함께 물어요. 한 질문에 욱여넣지 마세요. Jev는 원래 병렬로 답하고, 공식에 따륩면 질문을 몇 개 더 핮도 거의 느려지지 않아요.
덧붙이면, 공식 평가에서 큰 작업을 작은 판단들로 쪼갰더니 Luna의 점수조차 51.9%에서 66.8%로 올랐다는 걸 발견했어요. 그러니 최종적으로 Jev를 안 쓰더라도 이 습관은 들일 가치가 있어요.
3. 옵션을 빠짐없이 나열하고, 안전판을 하나 두기
현실에서 생각지 못한 경우가 나올 수 있다면 "기타"나 "판단 불가"를 추가해요. 그렇지 않으면 Jev는 어울리지 않는 옵션 중에서 억지로 하나를 골라야 하고, 그것도 아주 자신 있게 고를 수 있어요.
4. 점수 문제는 각 등급의 의미를 명확히 쓰기
"1~5점"이라고만 쓰지 말고, 각 등급이 어떤 상황에 해당하는지 써요:
"criteria": [
"대기열에 넣어도 됨: 정상 사용에 지장 없음",
"오늘 안에 처리: 일부 기능에 영향이 있지만 우회 방법이 있음",
"즉시 처리: 핵심 기능 사용 불가, 또는 자금·데이터 보안과 관련됨"
]
구체적으로 쓸수록 나오는 점수가 안정적이에요.
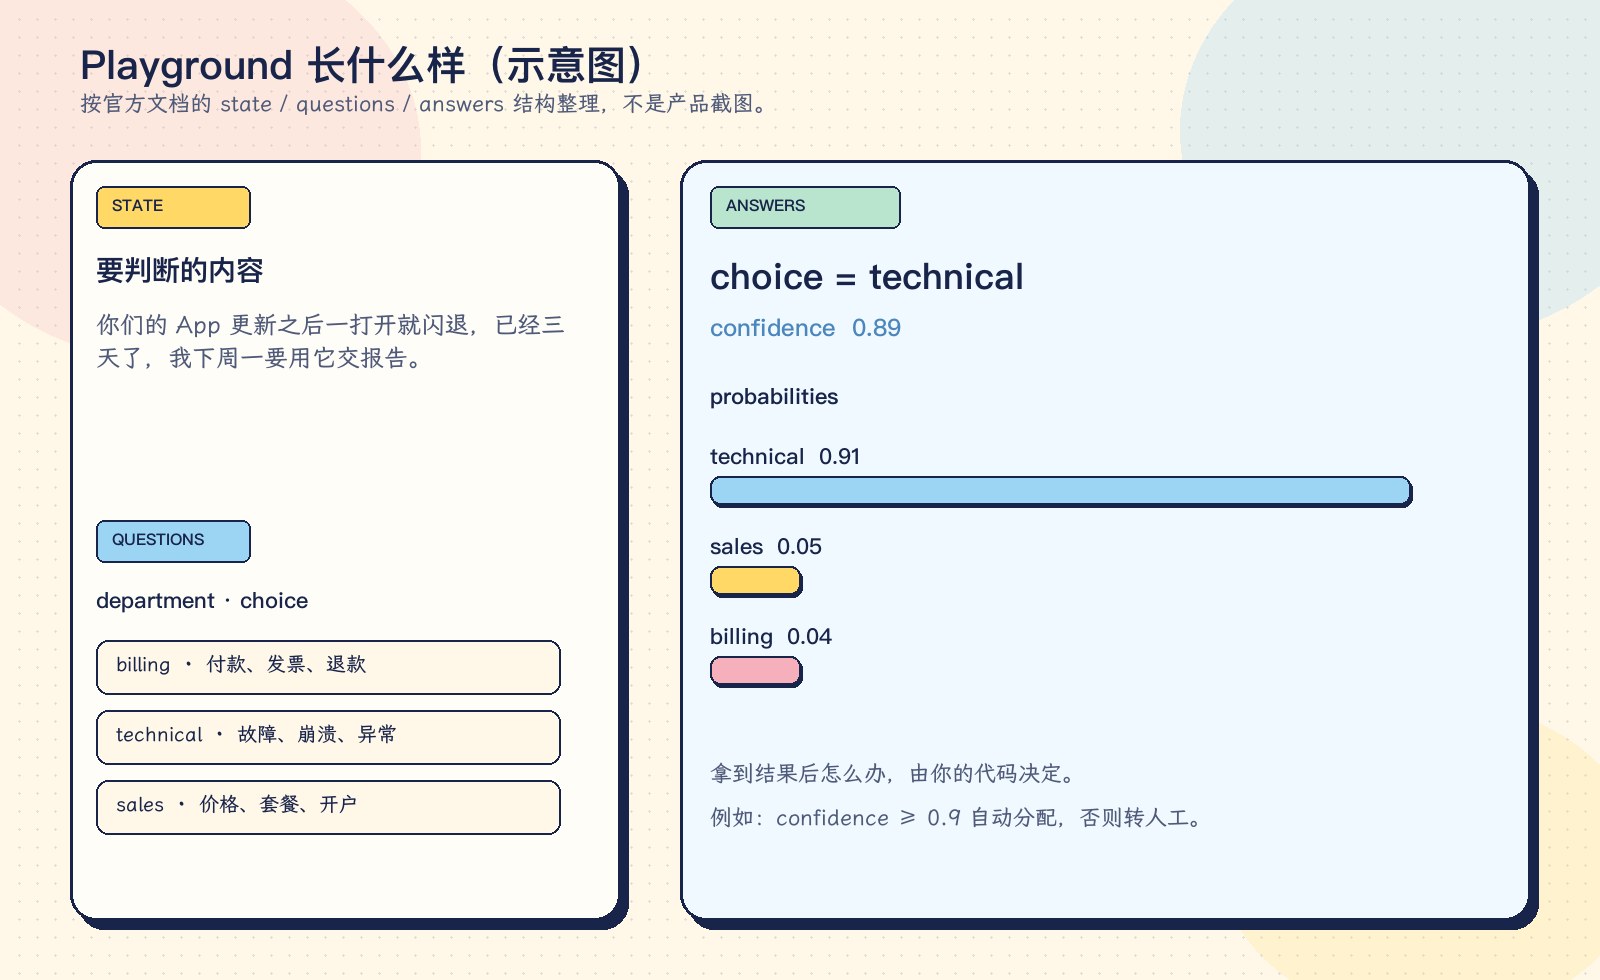
개념도. TypeSafe 공식 문서의 state / questions / answers 구조를 바탕으로 그렸고, 콘솔 스크린샷이 아니에요. 실제 Playground는 로그인이 필요해요: https://console.typesafe.ai/playground
마지막으로
Jev는 뭔가를 뒤집어엎는 존재가 아니에요. 대형 모델을 대체하지도 못하고, 코드 한 줄도 못 써요. 하는 일은 아주 좁아요: 소프트웨어가 판단을 필요로 하는 자리에서, 빠르고 싸게 답 하나와 임계값을 걸 수 있을 만한 확률 하나를 주는 것.
하지만 소프트웨어 안에는 바로 이런 작은 판단이 널려 있어요. 예전에는 하드코딩된 if-else 더미에 기대거나, 느릿하고 가끔 헛소리도 하는 대형 모델에 기댔어요. 이제 선택지가 하나 늘었어요: 말수가 적고, 손이 빠르고, 군더더기가 없는 분류기.
지금 당장 제 프로젝트에 붙일 거냐고요? 아마 제가 직접 라벨링한 데이터로 한번 돌려 보고, 보정과 오판이 어떻게 생겼는지 확인한 다음일 거예요. 공식의 "제로 환각"이라는 문구만 보고 덜컥 쓰진 않을 거예요. 스위치로는 좋지만, 두뇌로는 어울리지 않아요.
참고 출처
- TypeSafe 공식 발표: Introducing System One Models & Jev
- TypeSafe 문서: Introduction · Quick start
- TechCrunch: A new kind of AI model from a ChatGPT inventor is thrilling developers
- Vercel: TypeSafe AI's Jev now available on AI Gateway
- 커뮤니티 독립 테스트: Jev vs GPT-5.6 Luna vs Claude Sonnet 5(티켓 분류) https://github.com/BUNYOD0987/jev-vs-llm
- 커뮤니티 독립 테스트: Jev vs Luna(댓글 분류) https://github.com/mameli/jev-vs-luna
- 공식 평가 방법론 분석: https://dev.to/gabrielanhaia/jev-beat-gpt-luna-by-1-point-gpt-6-and-claude-wrote-the-answer-key-314k
- LiteLLM 문서: TypeSafe AI (Jev)
- OpenRouter 모델 페이지: https://openrouter.ai/~typesafe/jev-latest
- LangChain 통합: https://docs.langchain.com/oss/python/integrations/providers/typesafe