寫於 2026 年 9 月,Jev 發布後第五天。這東西變化很快,文中的價格、延遲和測試資料可能已經過時。我盡量對著官方文件和第一手來源核過一遍,但仍然建議你打開原文再看一眼。
這兩年我們已經習慣了 AI 話多。你問它今天是不是週一,它先給你講講星期制度的起源,再提醒你注意勞逸結合,最後問你還有什麼可以幫忙的。
然後 Jev 出現了。你問它問題,它只回你一個選項和一個機率,多一個字都沒有。像極了公司裡那個從不在群組裡發言、但交出來的活永遠不出錯的同事。
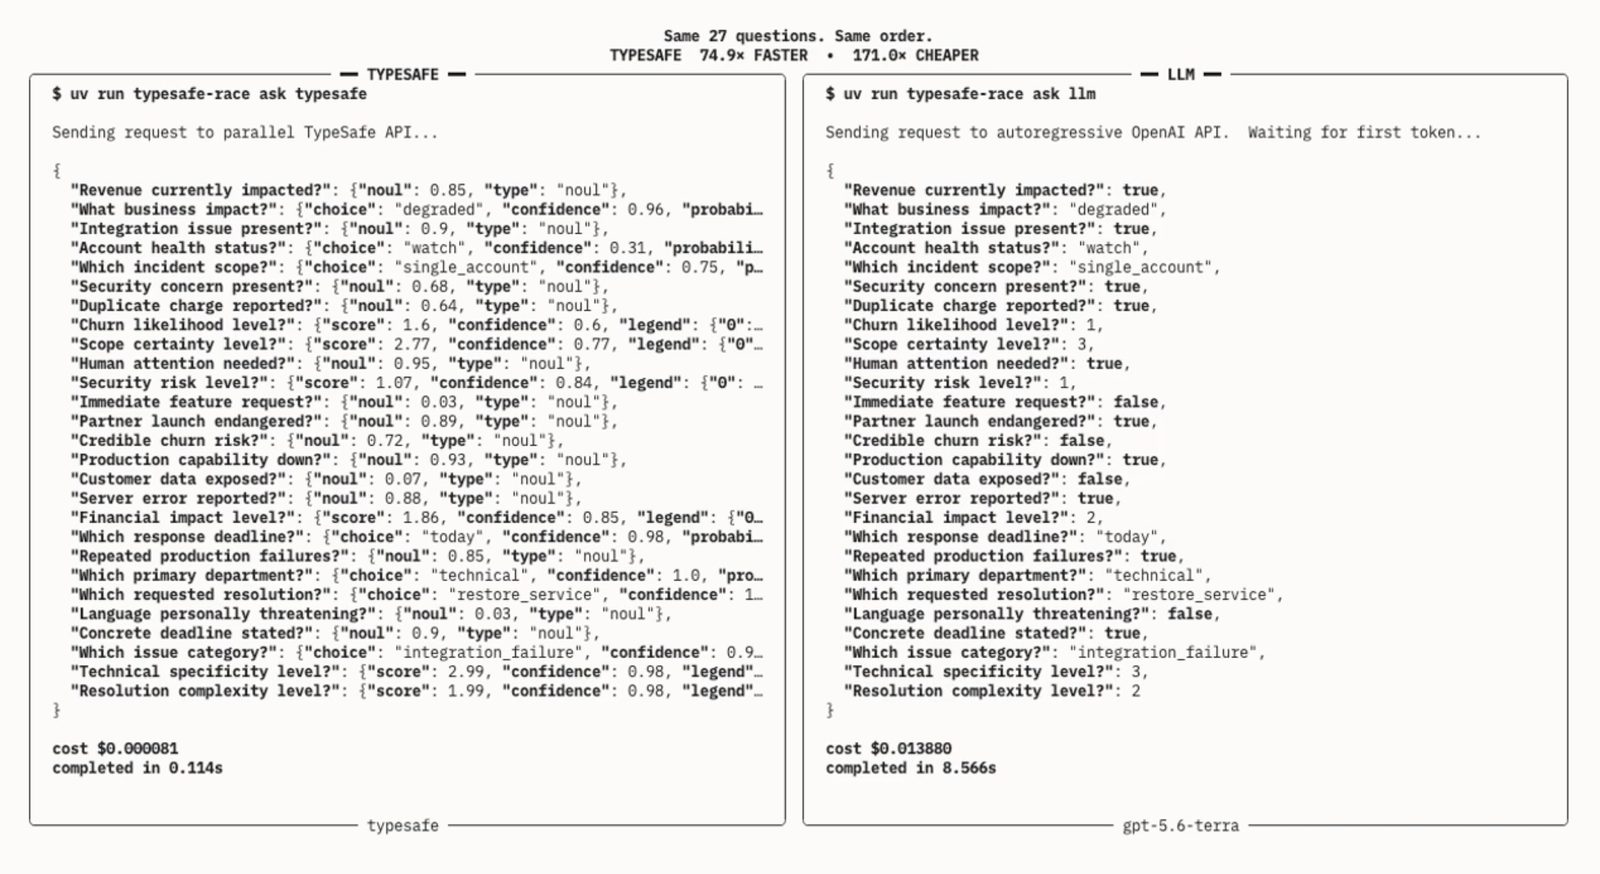
來源:TypeSafe AI 官方演示,經 TechCrunch 2026-09-18 報導轉載。截圖中的 74.9× / 171.0× 是那一次演示的結果,不是可以隨便外推的平均值。
一、Jev 是什麼
Jev 是 TypeSafe AI 在 2026 年 9 月 15 日放出的第一款公開模型。官方給它的類別名是 System One 模型:借用康納曼《快思慢想》裡「系統一」的說法,也就是那種不假思索、快速做判斷的直覺思維。和它相對的,是 ChatGPT、Claude 這類一個字一個字往外寫、慢慢想的大模型。模型名字來自經濟學家威廉·史丹利·傑文斯(William Stanley Jevons)——官方的意思是:智慧一旦變便宜,用量會漲,而不是縮。
創辦人 Diogo Almeida 是前 OpenAI 研究員。TechCrunch 的報導寫他參與過 ChatGPT,以及後來被稱為 RLHF 的那套指令跟隨訓練;他自己的發布文說得更窄一點:在 OpenAI 幫忙做過讓語言模型學會聽指令、跟人說話的方法。公司另外兩位共同創辦人是 Erik Gafni 和 Sasha Sheng。多家媒體寫 TypeSafe 同期完成了由 DCVC 領投的 4000 萬美元種子輪;我沒有在官方發布文裡看到融資細節,所以只把它當媒體報導,不當成公司蓋章的數字。
說人話就是:
Jev 是通用分類器。技術點在於不需要像傳統分類器一樣每個任務都做訓練。
以前你想讓機器自動給客服工單分類,得先找人標幾千筆資料,再訓練一個專門的模型。哪天老闆說要加一個「客訴」類別,好了,重新標註,重新訓練。Jev 把這一步刪掉了:分類標準在呼叫時直接用文字寫進去,改標準就是改幾行字的事。
另外說清楚一點:Jev 是閉源的。沒有開放權重,不能本地部署,只能走託管 API。官方發布文寫他們的評測是從美國西海岸的筆電跑的,“this is where our service is currently based”——可以理解為現在伺服器在美國西岸。官方 API 要排隊;Vercel AI Gateway 這條路目前不用等。
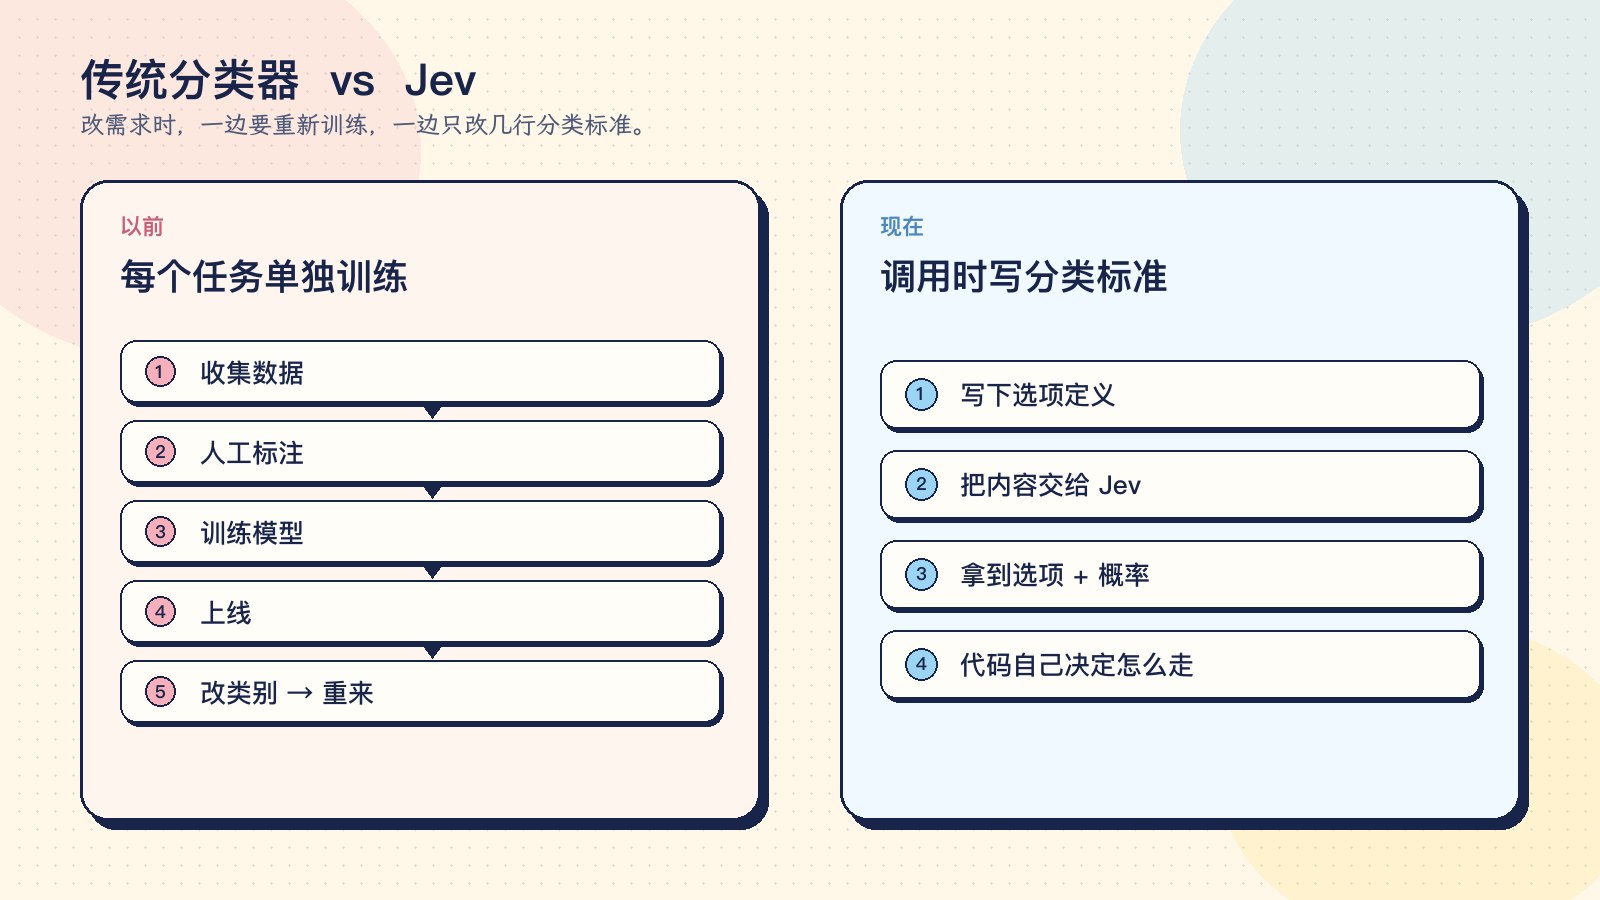
示意圖。左邊是傳統分類器的路徑,右邊是 Jev 的呼叫方式。
二、Jev 能做什麼
官方文件只給它三種問題,也就是三種「原語」:
- Choice / 選擇題:從你給的幾個選項裡挑一個,比如「這個工單該給哪個部門」。最多 255 個選項。
- Score / 評分題:在你定義好的有序等級裡評分,比如「這個問題有多緊急」。
- Noul / 是非題:給出「是」的機率。官方叫 Noul;Vercel 的 AI SDK 和 changelog 裡常寫成 Boolean。是同一類問題。
每個答案都附帶機率,選擇題和評分題還會給一個 confidence。這是它最有意思的地方,後面細說。
聽起來很樸素,但軟體裡其實到處都是這種判斷。典型的用法有這些:
- 工單和訊息分流:判斷該交給哪個團隊、緊急程度多高。
- Agent 的決策節點:下一步該呼叫哪個工具、該繼續、重試、問使用者還是停下。
- 安全檢查和護欄:在 AI 執行命令前判斷這個操作危不危險,或者檢查另一個模型的輸出有沒有越界。Vercel 工程師拿它換掉過 fx 預設模式裡跑在 Luna 上的命令安全審查。
- 模型路由:判斷一個請求是簡單問題還是難題,簡單的交給便宜的模型,難的再交給貴的模型。LangChain 已經做了現成的實驗性中介軟體
ModelRouterMiddleware,另外還有一個拿 Jev 攔高風險工具呼叫的AutoModeMiddleware。
適合它的場景有個共同特徵:答案能事先列出來,而且判斷次數多。一天判斷幾十次的事,用什麼模型都無所謂;一天判斷幾十萬次,或者每次使用者點擊都要判斷一次,Jev 的價值才出來。
反過來,需要它寫東西、算數、解釋為什麼這樣判斷的,都別找它。它是真的不會。官方自己也說:它放棄了字串生成。
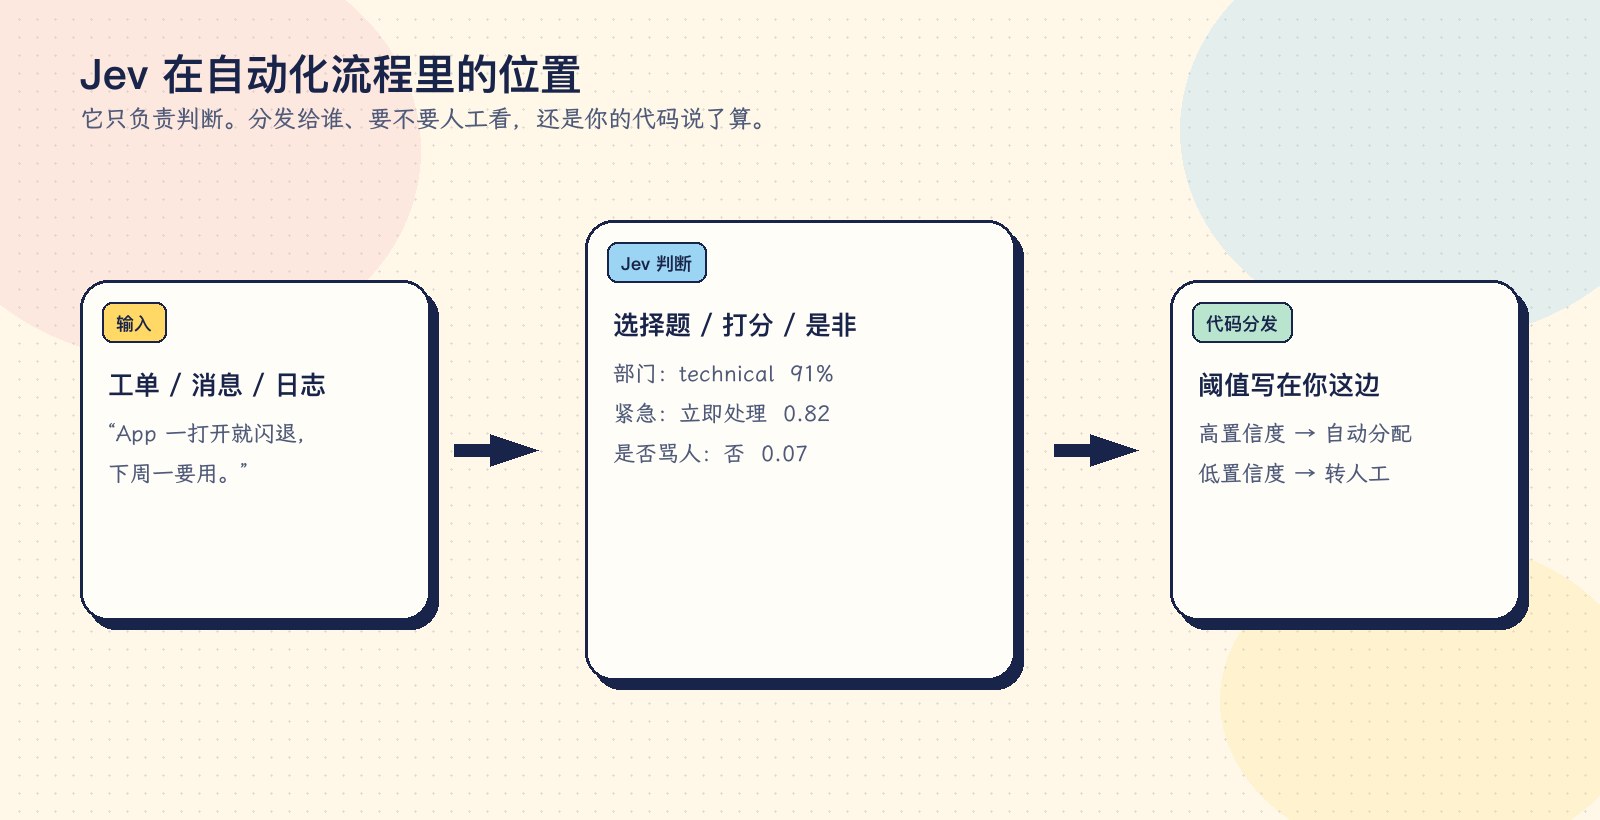
示意圖。Jev 只負責判斷;分發給誰、要不要人工看,仍然由你的程式決定。
三、它比 Luna 強在哪
Jev 的定價和定位,對標的就是 GPT-5.6 Luna、Claude Haiku 這一檔便宜又快的小模型。所以這裡拿 Luna 來比。數字分三層:官方自己的、Vercel 工程師的、社群獨立測試的。別混著讀。
1. 快
這是最實在的優勢。
社群裡有人做了獨立測試:一份 30 筆工單的分流測試裡,Jev 中位延遲 575 ms,Luna 1472 ms,大約快 2.6 倍;另一份評論分類測試裡,中位延遲 0.647 s 對 1.556 s,大約快 2.4 倍。官方的數字更誇張:端到端 70–500 ms,對大模型的 3–329 秒,並說在 System One 任務上可以到 40 到 200 倍。官網頁上那句 “193.6x Faster” 來自他們自己的 workflow evals,官方也承認這是「現實世界收益的偏高的一側」。Vercel 把 fx 裡的命令安全審查從 Luna 換成 Jev,工程師公開的說法是快了 5 到 18 倍(p95 到過 18 倍);Vercel 正式 changelog 沒有寫這組數字,只轉述了 TypeSafe 自己的 193.6 倍。
1 秒和 0.3 秒,對批次處理來說沒什麼區別。但如果判斷發生在使用者每次點擊之後,或者 AI Agent 每走一步之前,這點延遲就會一層層疊起來,最後變成使用者能感覺到的卡。
2. 便宜
官方定價寫得很清楚:輸入每百萬 token 0.042 美元(也就是每十億 token 42 美元),輸出免費,因為它根本沒什麼可輸出的。官方也坦白:他們沒法證明這個價格沒有補貼。
官網頁上的 “444.6x Cheaper” 是跟貴的大模型、按他們自己的 workflow 比出來的。和 Luna 比,兩份社群獨立測試大概便宜 4 到 5 倍:工單測試裡每 1000 筆 0.022 美元對 0.088 美元;評論測試裡已知單次成本大約 0.000032 美元對 0.000154 美元。
說實話,Luna 本來就夠便宜了,這點價差對大多數人來說無關痛癢。量大到一定程度才有意義。
3. 機率可以信
這是 Jev 真正獨特的地方。你讓 Luna 給個信心水準,它說 0.9,這個數字更像是它「說出來」的,不太能反映它實際對不對。TypeSafe 專門用一套叫 RLCD(Reinforcement Learning for Calibrated Decisions)的方法訓練這件事,目標是它說 90% 的時候,真的大約有 90% 是對的。
如果這點靠得住,就能做一件很實用的事:高信心水準的直接自動處理,低信心水準的轉給人工。對公司來說,省下的人工複核成本比省 API 費用值錢多了。不過目前這個說法還主要來自官方,訓練細節和校準誤差都沒有公開論文。建議自己用真實資料驗證一下。
4. 不會輸出格式錯誤的答案
用 Luna 做分類,偶爾會遇到它回傳的 JSON 格式不對、或者編了一個你沒給過的選項。Jev 從結構上就不會出這種問題,它只能從你定義的選項裡選。
官方把這叫做「零幻覺」。這個說法要打個折扣:官方自己解釋過,這個 0% 不是實測出來的,而是 “schema matching is guaranteed”——它不會給出不存在的選項,但完全可能選錯一個存在的選項,而且還可能選得很自信。
老實交代一下準確率
準確率上 Jev 並沒有穩贏。
- 社群 30 筆工單測試:Luna 三項全對 28/30,Jev 25/30。Jev 典型的錯法,是把兩條語氣很平靜的故障報告判成「客戶生氣」。
- 社群 100 條評論、各跑 3 次:Luna 欄位準確率 97.13%,Jev 96.13%,差 1 個百分點。作者自己也寫了,這是合成資料,不能當通用排名。
- 官方 workflow evals:Jev 67.8%,Luna 66.8%,Jev 高 1 分。但這套評測的標準答案是 GPT-6 Astra 和 Claude Fable 5.1 的平均輸出,沒有人工標註。Dev.to 上有一篇把這個方法拆得很清楚。
這些測試樣本都不大,誰也不能說明什麼。我自己的結論就是:準確率差不多,Jev 贏在快、便宜、格式不會跑飛,以及它願意給一個你可以拿來設閾值的機率。
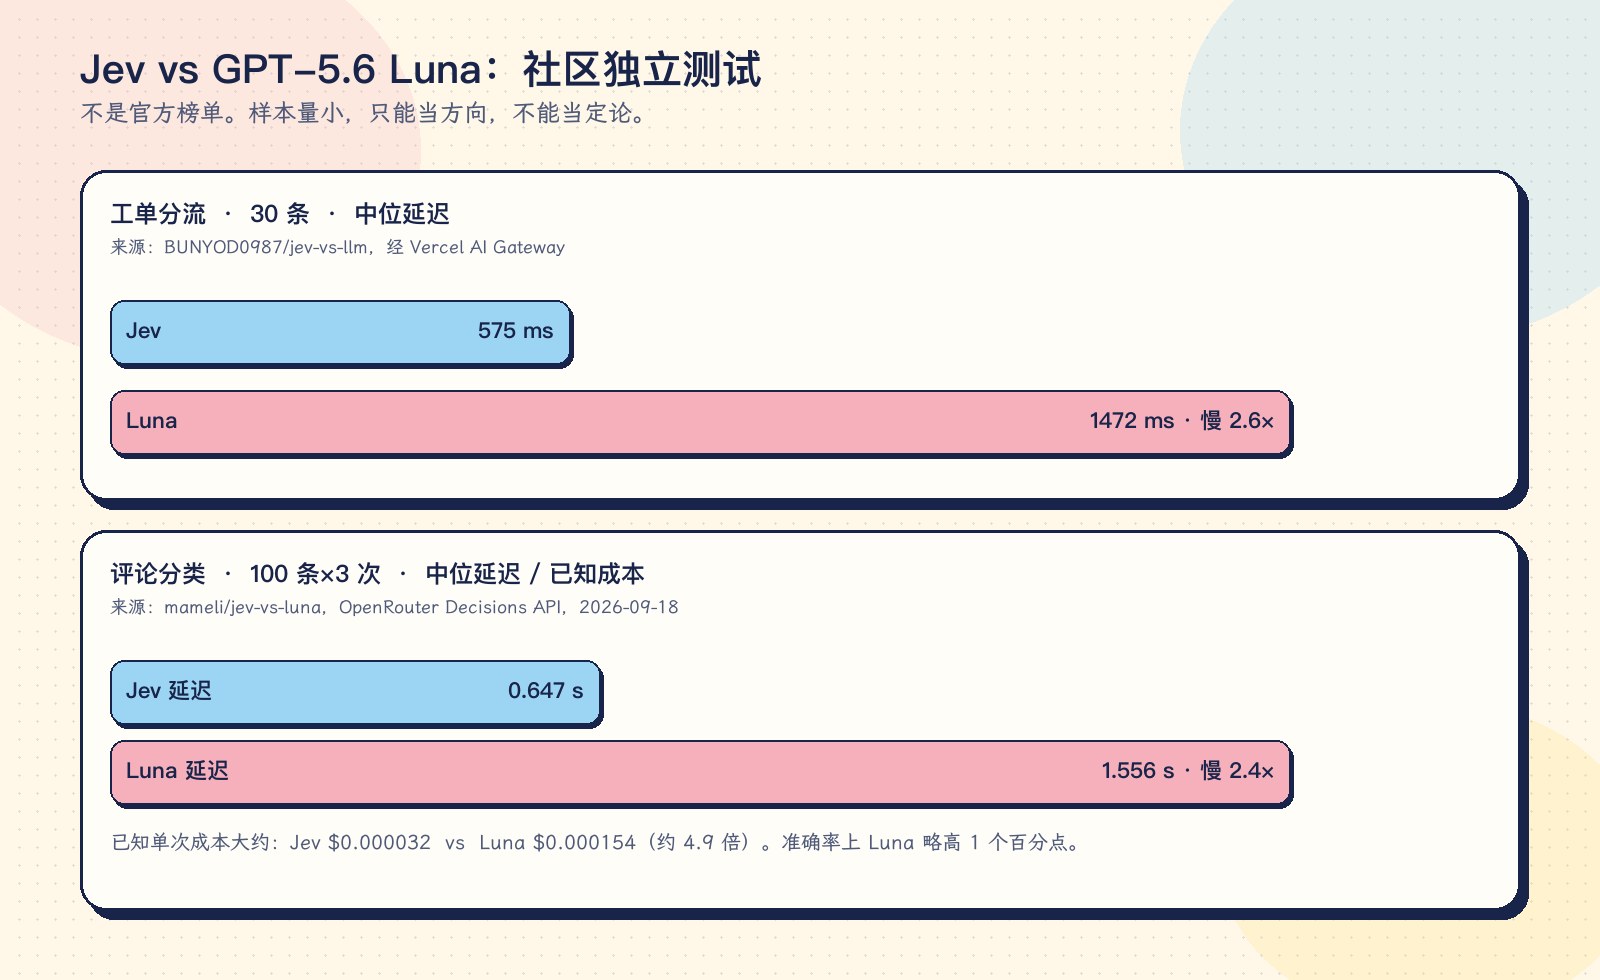
根據 BUNYOD0987/jev-vs-llm 與 mameli/jev-vs-luna 公布的數字重繪。樣本量小,只表示這兩次測試裡的方向。
四、怎麼用
接入
目前我看到三條路:
- 官方 API:
POST https://api.typesafe.ai/v1/systemone,模型 ID 是jev-latest。需要先排隊申請資格。 - Vercel AI Gateway:不用排隊,模型 ID 是
typesafe-ai/jev,changelog 寫價格一樣。AI SDK 7 用實驗性的evaluate介面。 - OpenRouter:模型 ID 是
~typesafe/jev-latest,走它的 Decisions API,不是普通 chat completions。我查到的標價同樣是輸入 0.042 美元 / 百萬 token,輸出 0。
LiteLLM 也接了透傳:把 https://api.typesafe.ai 換成代理的 /typesafe 即可。
呼叫長什麼樣
你要給它兩樣東西:state 是要判斷的內容,questions 是你要問的問題,可以一次問好幾個,它會並行回答。下面按官方文件的結構寫,工單內容換成我更熟悉的例子:
POST https://api.typesafe.ai/v1/systemone
{
"model": "jev-latest",
"state": "你們的 App 更新之後一打開就閃退,已經三天了,我下週一要用它交報告。",
"questions": {
"department": {
"type": "choice",
"instructions": "這個工單應該交給哪個團隊?",
"criteria": {
"billing": "付款、發票、退款相關",
"technical": "故障、當機、功能異常",
"sales": "價格諮詢、方案升級、新開帳號"
}
}
}
}
回傳的大致是這樣(示意,不是一次真實呼叫的原文):
{
"answers": {
"department": {
"type": "choice",
"choice": "technical",
"probabilities": { "billing": 0.04, "technical": 0.91, "sales": 0.05 },
"confidence": 0.89
}
}
}
是非題在官方回應裡是 "type": "noul" 加一個 0 到 1 的 noul 欄位;Vercel SDK 裡你會看到 boolean 和 probability。拿到結果後怎麼辦,由你自己的程式決定。比如信心水準高於 0.9 就自動分配,低於這個數就推給人工看一眼。
重點:寫好提示詞
Jev 的「提示詞」和給大模型寫 prompt 不太一樣。它不是一大段話,而是拆成了三塊:要判斷的內容、每個問題問什麼、每個選項的定義。效果好不好,主要看選項的定義寫得清不清楚。 以前花在標註資料上的功夫,現在花在這裡。
幾個要點:
1. 選項之間的邊界要寫死
上面那份 30 筆工單測試裡,Jev 把兩條語氣很平靜的故障報告判成了「客戶生氣」。原因很好猜:它把「問題很嚴重」和「客戶很生氣」混為一談了。
模糊的寫法:
"criteria": {
"angry": "客戶很生氣",
"calm": "客戶不生氣"
}
清楚的寫法:
"criteria": {
"angry": "措辭中有明顯的情緒表達,比如指責、反問、感嘆、威脅負評或退款。只看語氣,不看問題本身有多嚴重。",
"calm": "語氣平靜地描述問題。哪怕問題很嚴重(比如系統完全癱瘓),只要措辭平靜,就算這一類。"
}
第二種寫法把最容易混淆的情況直接點了出來。你覺得哪裡可能判錯,就把哪裡寫進定義。
2. 一個問題只問一件事
想知道該給哪個部門、有多緊急、要不要退款,就拆成三個問題一起問,不要塞進一個問題裡。Jev 本來就是並行回答的,官方說多問幾個問題幾乎不會變慢。
順便說一句,官方評測裡發現,把大任務拆成一堆小判斷後,連 Luna 的得分都從 51.9% 漲到了 66.8%。所以就算最後不用 Jev,這個習慣也值得養成。
3. 選項要列全,並留一個兜底項
如果現實裡可能出現你沒想到的情況,就加一個「其他」或「無法判斷」。不然 Jev 只能在不合適的選項裡硬選一個,而且還可能選得很自信。
4. 評分題要寫清每一檔是什麼意思
不要只寫「1 到 5 分」,要寫清楚每一檔對應什麼情況:
"criteria": [
"可以排隊處理:不影響正常使用",
"今天內處理:部分功能受影響,但有替代辦法",
"立即處理:核心功能不可用,或涉及資金、資料安全"
]
寫得越具體,打出來的分越穩定。
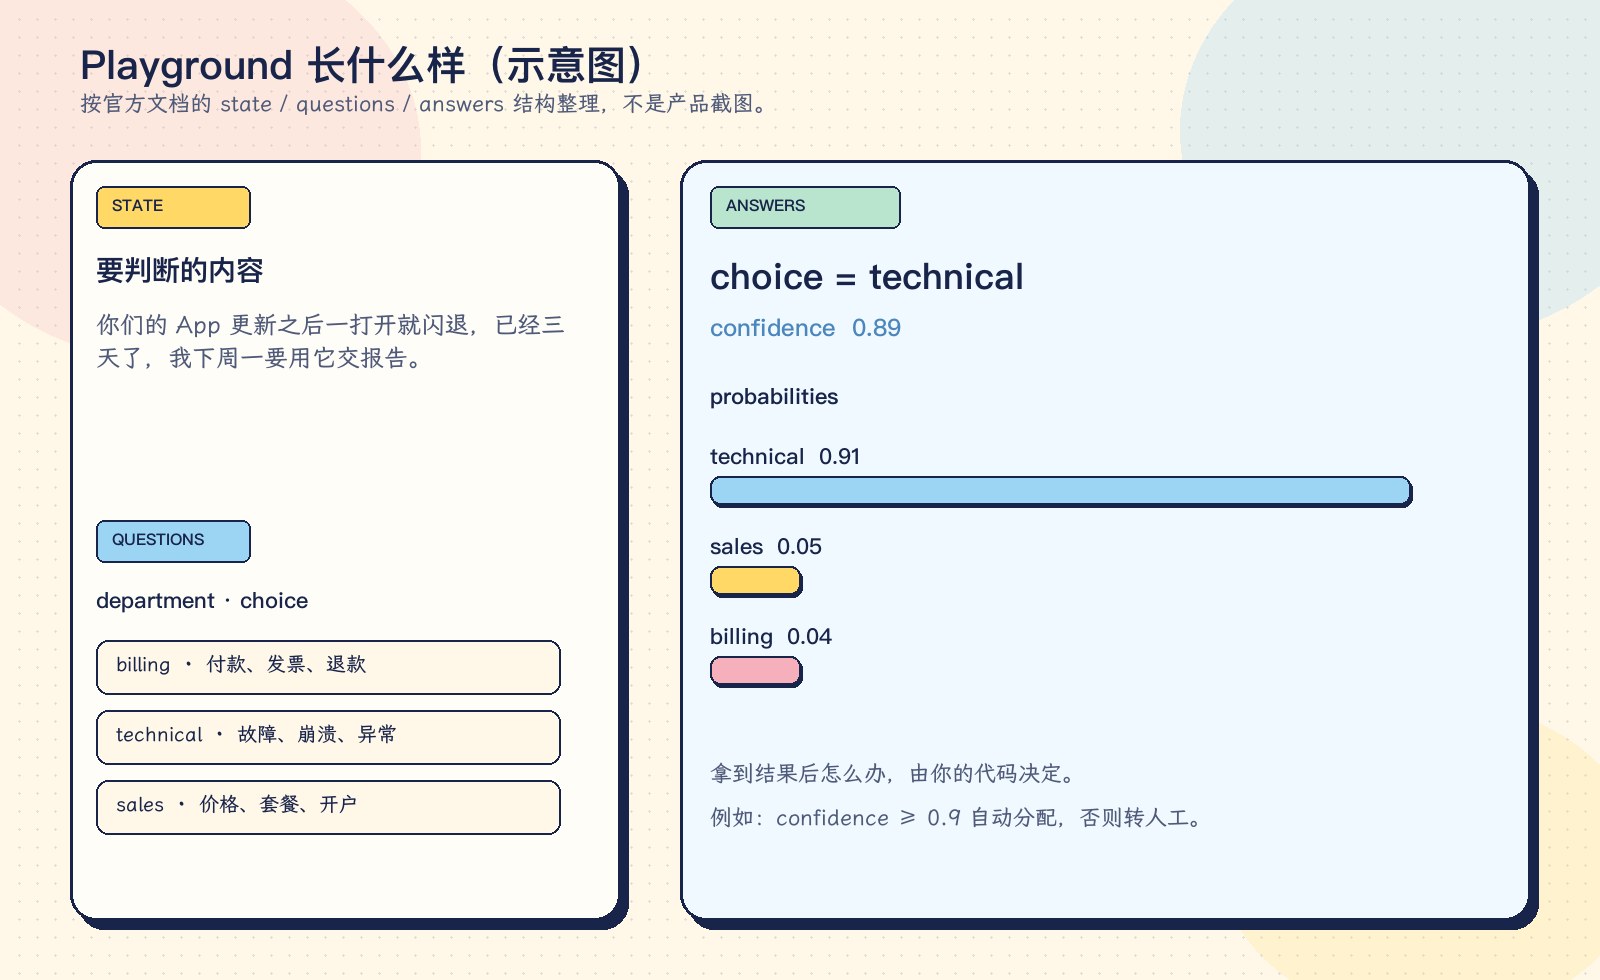
示意圖,依據 TypeSafe 官方文件的 state / questions / answers 結構繪製,不是控制台截圖。真實 Playground 需要登入:https://console.typesafe.ai/playground
最後
Jev 不是什麼顛覆性的東西,它不會取代大模型,也寫不出一行程式。它做的事情很窄:在軟體需要做判斷的地方,又快又便宜地給出一個答案和一個你大概可以拿來設閾值的機率。
但軟體裡恰恰到處都是這種小判斷。以前它們要麼靠一堆寫死的 if-else,要麼靠一個慢吞吞、偶爾還會亂說話的大模型。現在多了一個選擇:一個話少、手快、從不廢話的分類器。
我會不會現在就把它接到自己的專案裡?大概會先拿一批自己標過的資料跑一遍,看校準和誤判長什麼樣,而不是看完官方那句「零幻覺」就上。它適合當開關,不適合當大腦。
參考來源
- TypeSafe 官方發布:Introducing System One Models & Jev
- TypeSafe 文件:Introduction · Quick start
- TechCrunch:A new kind of AI model from a ChatGPT inventor is thrilling developers
- Vercel:TypeSafe AI's Jev now available on AI Gateway
- 社群獨立測試:Jev vs GPT-5.6 Luna vs Claude Sonnet 5(工單分類)https://github.com/BUNYOD0987/jev-vs-llm
- 社群獨立測試:Jev vs Luna(評論分類)https://github.com/mameli/jev-vs-luna
- 對官方評測方法的分析:https://dev.to/gabrielanhaia/jev-beat-gpt-luna-by-1-point-gpt-6-and-claude-wrote-the-answer-key-314k
- LiteLLM 文件:TypeSafe AI (Jev)
- OpenRouter 模型頁:https://openrouter.ai/~typesafe/jev-latest
- LangChain 整合:https://docs.langchain.com/oss/python/integrations/providers/typesafe